
Tekst powstał w ramach projektu WP Opinie. Przedstawiamy w nim zróżnicowane spojrzenia komentatorów i liderów opinii publicznej na kluczowe sprawy społeczne i polityczne.
Najpierw jednak trzeba uczciwie powiedzieć, dlaczego takie systemy są potrzebne i dlaczego nie możemy liczyć wyłącznie na platformy, które zarabiają na emisji reklam.
Scam nie kradnie tylko twarzy. Kradnie zaufanie
Gdy w fałszywej reklamie pojawia się prezydent, znany biznesmen, lekarz albo rozpoznawalna marka banku, najłatwiej zauważyć kradzież wizerunku. Osoba publiczna jest ofiarą: ktoś bez jej zgody wykorzystuje twarz, głos i reputację. Jednak ekonomiczny cel ataku znajduje się po drugiej stronie ekranu. To senior, który uwierzy, że państwo uruchomiło specjalny program inwestycyjny. Osoba zadłużona, która desperacko szuka dodatkowego dochodu. Człowiek w trudnej sytuacji, któremu fałszywy autorytet obiecuje szybki i bezpieczny zysk.
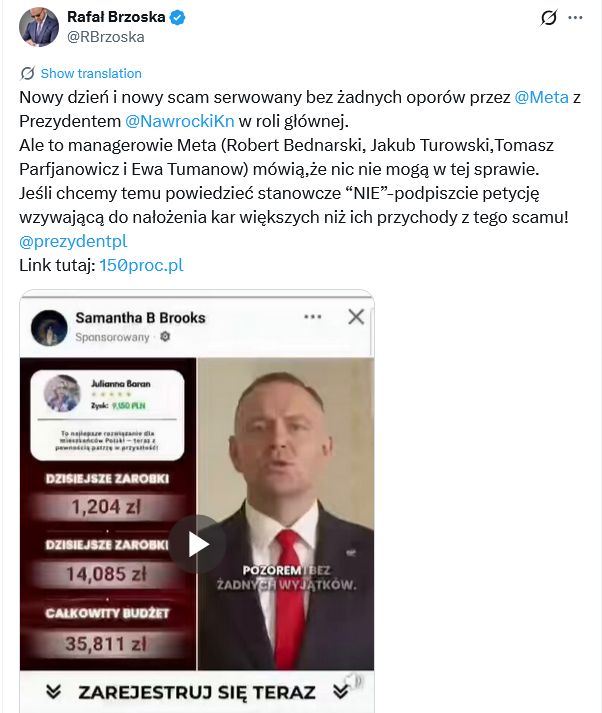
Oszust nie sprzedaje kryptowaluty ani cudownej inwestycji. Sprzedaje zaufanie pożyczone od kogoś, komu odbiorca już ufa. Dlatego scam nie jest marginalnym problemem moderacji treści. Jest zautomatyzowanym transferem wiarygodności od instytucji, marek i ludzi do przestępców. A jego koszt ponoszą często osoby, dla których utrata kilku lub kilkudziesięciu tysięcy złotych oznacza utratę bezpieczeństwa na lata.
DLA CIEBIEPrzetestował setki zawodów. Który wybrałby na start? - Wojciech Kaczmarczyk II Pierwsza praca #4
Kiedy pokazuję takie reklamy, rozmowa bardzo szybko schodzi na jakość deepfake'u: czy usta poruszają się naturalnie, czy głos brzmi przekonująco, czy cień pod brodą się zgadza. To ciekawe, ale trochę przypomina badanie jakości lakieru w samochodzie, który nie ma silnika. Zanim zaczniemy analizować piksele, warto zapytać: kto tę reklamę kupił, kto za nią zapłacił i dlaczego konto bez historii nagle dysponuje dużym budżetem na kampanię inwestycyjną w Polsce?
Fabryka scamu nie potrzebuje już fabryki ludzi
Jeszcze niedawno przygotowanie wiarygodnego oszustwa wymagało zespołu: kogoś od grafiki, montażu, strony internetowej, tekstu i obsługi kampanii reklamowej i znajomości języka. Generatywna AI radykalnie obniżyła koszt każdego z tych etapów. Przestępca może sklonować głos osoby publicznej, poruszyć jej usta w spreparowanym nagraniu, wygenerować fałszywy artykuł stylizowany na portal informacyjny, skopiować identyfikację banku, uruchomić stronę na świeżo kupionej domenie i stworzyć dziesiątki wersji reklamy.
Gdy jedna zostanie zablokowana, kolejne różnią się kadrem, nagłówkiem, domeną albo nazwą konta. Produktem nie jest pojedynczy deepfake. Produktem jest cały łańcuch dystrybucji oszustwa. AI pozwala więc produkować scam przemysłowo. Jednak ten sam proces pozostawia mnóstwo śladów.
Ktoś opłacił reklamę. Ktoś założył konto reklamowe. Ktoś kupił domenę. Kampania ma język, kraj emisji, grupę odbiorców, budżet, stronę docelową i historię zmian. Strona korzysta z określonej infrastruktury, certyfikatów i skryptów. Obraz, tekst i zachowanie linku można porównać z tysiącami innych przypadków.
Przestępcy oczywiście maskują te ślady. Ukrywają dane rejestracyjne domen, korzystają z pośredników, przejętych kont i infrastruktury rozproszonej po wielu państwach. Stosują cloaking: automatowi kontrolnemu pokazują niewinną stronę lub zdjęcie ptaka, a polskiemu użytkownikowi – fałszywą inwestycję.
No dobrze, pojawił się ptaszek. Sprawa rozwiązana? Niekoniecznie. Pozostaje pytanie, dlaczego firma z Azji, nosząca nazwę przypominającą efekt krótkiej drzemki na klawiaturze, np. "mia", "abc", "qwe", kupuje drogą kampanię dla Polaków, reklamuje ptaszka i przekierowuje ruch do kanadyjskiego Amazona. Oszuści skomplikowali drogę, ale nie uczynili jej logiczną. Ukrycie jednego elementu nie sprawia, że cała historia nagle zaczyna mieć sens.
Wyobraźmy sobie reklamę skierowaną do Polaków. Publikuje ją świeże konto udające salon kosmetyczny z Nowego Jorku, za kampanią stoi podmiot z Wietnamu, profil ma zero obserwujących, zero obserwowanych i żadnej wiarygodnej historii, a film pokazuje polskiego prezydenta zachęcającego do zakupu kryptowaluty. Link deklaruje jedno miejsce, po drodze wykonuje serię przekierowań, a systemowi kontrolnemu pokazuje kanadyjski Amazon. Jakie jest prawdopodobieństwo, że to prawdziwa kampania? Podpowiem: zadanie nie wymaga doktoratu z uczenia maszynowego. To raczej poziom rozsądnego maturzysty, który nie zasnął podczas czytania polecenia.
Do odpowiedzi nie potrzeba AGI, laboratorium za miliardy dolarów ani największego modelu językowego świata. Kompaktowy model uruchomiony na zwykłym laptopie potrafi zauważyć, że elementy tej historii do siebie nie pasują. Zwykły system reguł może zatrzymać część takich kampanii jeszcze wcześniej. W obserwowanych przez nas przypadkach zdarzały się reklamy, w których nazwa płatnika brzmiała po prostu "1". Proponuję prosty eksperyment. Wejdźmy do dowolnego sklepu, poprośmy o fakturę i na pytanie o nazwę firmy odpowiedzmy: "1". Jest spora szansa, że sprzedawca uniesie brew i poprosi o prawdziwe dane i odmówi sprzedaży. System reklamowy obracający ogromnymi budżetami powinien umieć zrobić przynajmniej tyle co człowiek stojący przy kasie.
Lider AI nie może udawać, że nie rozumie reklamy
Tu dochodzimy do Mety. Zaraz, zaraz: mówimy przecież o jednym z globalnych liderów sztucznej inteligencji, twórcy rodziny modeli Llama. To nie jest mała firma, której zabrakło serwera, danych albo dwóch inżynierów. Meta potrafi analizować zachowania miliardów użytkowników i z niezwykłą precyzją zdecydować, komu pokazać reklamę butów, kredytu czy wakacji.
Naprawdę mamy uwierzyć, że ta sama firma nie potrafi zauważyć, iż salon kosmetyczny z Nowego Jorku, prowadzony z Wietnamu, sprzedaje Polakom kryptowaluty ustami polskiego prezydenta? Nie kupuję tego.
Meta odpowiada, że walczy z oszustwami, inwestuje w automatyczne systemy ochrony i rozszerza weryfikację reklamodawców usług finansowych. Dobrze. Tylko że z perspektywy technicznej pytanie nie brzmi: czy Meta robi cokolwiek?
Pytanie brzmi: dlaczego system w ogóle dopuszcza do emisji reklamę, której elementy są tak absurdalnie niespójne? Nie oczekuję od platformy nieomylności. Oszuści zmieniają metody, przejmują konta, rotują domeny i uczą się obchodzić filtry. Właśnie dlatego obrona nie może być pojedynczym filtrem patrzącym wyłącznie na obraz albo tekst. Powinna łączyć kontekst: kim jest reklamodawca, kto płaci, skąd pochodzi konto, dokąd prowadzi link, co przedstawia film i do kogo skierowano kampanię.
To jest sedno mojego zarzutu wobec Mety. Nie chodzi o to, że firma nie zatrzymała każdego oszustwa. Chodzi o to, że wiele kampanii przechodzi przez system mimo zestawu sygnałów, które współczesna technologia potrafi rozpoznać bez budowania cyfrowego Einsteina. Jeśli te sygnały są dostępne, a reklama nadal trafia do użytkowników, trudno mówić wyłącznie o nieuniknionym błędzie skali.
Biblioteka reklam, która traci najważniejsze dowody
Europa stworzyła narzędzie, które mogłoby istotnie pomóc w kontroli platform. Akt o usługach cyfrowych, czyli DSA, zobowiązuje największe platformy do prowadzenia publicznych repozytoriów reklam. Powinny one pozwolić wyszukiwać reklamy i zawierać między innymi ich treść, dane podmiotu, w imieniu którego są emitowane, dane płatnika, okres emisji, podstawowe parametry targetowania i zasięg. Informacje mają być dostępne podczas emisji i przez rok po jej zakończeniu. W teorii to znakomity publiczny sensor. Niezależny system może obserwować reklamy, łączyć warianty, analizować płatników, odkrywać świeże domeny i sprawdzać, czy ta sama operacja pojawia się pod kolejnymi nazwami.
W praktyce natrafiamy na poważne ograniczenia. W kampaniach korzystających z dynamicznej optymalizacji materiał widziany przez konkretnego użytkownika nie zawsze daje się później wiernie odtworzyć na podstawie tego, co udostępnia biblioteka. Jeszcze większy problem pojawia się po usunięciu reklamy.
Sam art. 39 ust. 3 DSA przewiduje, że jeśli platforma zdejmie reklamę z powodu podejrzenia nielegalności lub niezgodności z regulaminem, repozytorium nie musi dalej pokazywać jej treści ani danych reklamodawcy i płatnika. Pozostaje informacja o decyzji moderacyjnej. Powstaje paradoks godny cyfrowego archiwum: najcenniejszy materiał do badania nowych metod oszustów może zniknąć właśnie wtedy, gdy zostanie rozpoznany jako szkodliwy. To trochę tak, jakby z policyjnego magazynu dowodów usuwano przedmiot natychmiast po potwierdzeniu, że pochodzi z przestępstwa.
Zatem z punktu widzenia bezpieczeństwa publicznego obecna transparentność jest niewystarczająca. System, który pozwala zobaczyć reklamę dopiero po jej emisji, nie zawsze pokazuje wszystkie warianty, a po interwencji usuwa kluczowe dowody, nie jest pełnym radarem. Jest oknem z ograniczonym polem widzenia.
Zamiast jednego sędziego zespół cyfrowych śledczych
Właśnie z tego powodu w Augurium zbudowaliśmy techniczne serce ScamWatch. Jestem częścią tego zespołu, więc opisuję rozwiązanie z perspektywy jego twórców, a nie neutralnego obserwatora. ScamWatch nie opiera się na jednym modelu, który ogląda reklamę i wydaje magiczny werdykt: "scam" albo "nie scam". Taki klasyfikator łatwo oszukać niewinnym obrazem, drobną zmianą tekstu albo przekierowaniem.
System agentowy przypomina raczej pokój pełen wyspecjalizowanych śledczych – tylko bez tablicy korkowej, czerwonego sznurka i zimnej kawy. Jeden analizuje obraz i szuka manipulacji albo bezprawnego użycia wizerunku. Drugi czyta tekst i ocenia obietnice zysku. Trzeci sprawdza domenę, jej wiek, przekierowania i powiązaną infrastrukturę. Kolejny bada reklamodawcę i płatnika. Inny porównuje kreację z wcześniejszymi kampaniami, a jeszcze inny testuje stronę z różnych lokalizacji, aby wykryć cloaking.
Na końcu agent koordynujący składa te ustalenia w ocenę ryzyka i materiał dowodowy z uzasadnieniem.
To ważna różnica. Pojedyncza anomalia może być przypadkiem. Nowa domena nie zawsze jest zła. Zagraniczny reklamodawca może legalnie prowadzić kampanię w Polsce. Nietypowa nazwa płatnika może wynikać z błędu. Jednak kiedy świeża domena, fałszywy autorytet, spójność geograficzna, podejrzany płatnik, przekierowania i znany wzorzec obrazu występują razem, prawdopodobieństwo przypadku gwałtownie maleje. Przestępca może oszukać jeden filtr. Znacznie trudniej oszukać jednocześnie kilkanaście niezależnych źródeł informacji.
Taki system udało się nam uruchomić w ciągu kilku dni, korzystając ze środowiska agentowego i dostępnych modeli. Nie podaję tego jako dowodu, że problem scamu jest prosty. Utrzymanie jakości, ograniczanie fałszywych alarmów, działanie w skali i nadążanie za przeciwnikiem są trudne. Pokazuje to jednak, że próg wejścia do skutecznej obrony jest znacznie niższy, niż sugerowałaby skala globalnej platformy. Jeśli mały polski zespół może zbudować działający mechanizm analizy, technologiczny gigant nie może wiarygodnie zasłaniać się samą skalą problemu.
Frontier model to nie cała wojna o AI
W debacie o sztucznej inteligencji często słyszymy, że Polska i Europa przegrały wyścig z USA i Chinami. Bywa to wypowiedziane tonem komentatora sportowego, który po pierwszej konkurencji ogłasza koniec całych igrzysk. Jeśli miarą jest liczba najpotężniejszych modeli bazowych, dostęp do największych klastrów GPU i miliardy dolarów wydawane na pojedynczy trening, rzeczywiście jesteśmy poza czołówką.
Nie wynika z tego jednak, że jesteśmy skazani na technologiczną zależność. Frontier model jest potężnym silnikiem, ale sam silnik nie tworzy systemu obrony granic, cyberbezpieczeństwa, diagnostyki przemysłowej ani wykrywania scamu.
Przewaga powstaje również z połączenia modeli specjalizowanych, agentów, narzędzi, pamięci, danych domenowych, procedur weryfikacji i ludzi rozumiejących konkretny problem.
W tym obszarze Polska może być numerem jeden. Powinna rozwijać małe i średnie modele wyspecjalizowane w kodowaniu, analizie obrazu, języku polskim, cyberbezpieczeństwie, robotyce i pracy na danych wrażliwych. Powinna umieć koordynować ich pracę w rojach agentów, mierzyć ich skuteczność i uruchamiać je na infrastrukturze, nad którą zachowuje kontrolę. Nie zamiast inwestycji w modele bazowe, lecz obok nich.
To jest praktyczny wymiar suwerenności technologicznej, o której mówimy w Radzie Przyszłości. Suwerenność nie oznacza, że wszystko musimy wynaleźć i wyprodukować sami. Oznacza, że gdy interes polskiego obywatela, państwa lub gospodarki przestaje pokrywać się z interesem globalnej platformy, potrafimy zbudować własną zdolność działania. Potrzebujemy do tego instytucji, która będzie umiała szybko łączyć potrzeby państwa z technologią powstającą w startupach, nauce i sektorze cywilnym – polskiego odpowiednika Defence Innovation Unit (również rekomendacja Rady Przyszłości).
Nie kolejnego programu, w którym przez dwa lata opisuje się problem, powołuje zespół do zespołu i na końcu produkuje elegancki PDF. Potrzebujemy mechanizmu zamawiania prototypów, testowania ich w realnych warunkach i skalowania tego, co działa.
Architektura agentowa nie należy do jednej branży. Jeden rój może bronić obywateli przed oszukańczą reklamą, inny monitorować cyberataki, jeszcze inny analizować obraz z sensorów na granicy. W e-commerce agent może dobierać produkt, w fabryce diagnozować maszynę, a w administracji sprawdzać zgodność dokumentów. To nie są te same systemy. Wspólny jest sposób budowania zdolności: wiele wyspecjalizowanych elementów współpracujących wokół jasno określonego celu.
Najpierw obrońmy obywatela
Polska nie powinna czekać, aż interes globalnej platformy przypadkiem stanie się zgodny z interesem polskiego obywatela. Powinna wymagać odpowiedzialności, lepszej transparentności i skutecznej weryfikacji reklamodawców. Równocześnie musi budować własne radary: publiczne, społeczne i komercyjne systemy zdolne wykrywać zagrożenia, dokumentować je i wymuszać reakcję.
Czy musimy mieć największy model AI na świecie, żeby wygrać technologiczną walkę ze scamem? Nie. Musimy mieć własne kompetencje, dane, instytucje i zespoły zdolne zamieniać dostępne modele w systemy, które chronią ludzi lepiej niż rozwiązania oferowane nam przez globalne platformy. Jeżeli nie potrafimy ochronić obywatela przed komputerowo wygenerowanym prezydentem sprzedającym kryptowaluty, trudno poważnie mówić o suwerenności AI. Jeżeli potrafimy – być może właśnie znaleźliśmy część technologicznego wyścigu, której Polska wcale nie musi przegrać.
Sebastian Kondracki jest programistą, ekspertem w dziedzinie sztucznej inteligencji i transformacji cyfrowej. Pracuje jako Chief Innovation Officer w firmie Devinti. Jest autorem licznych raportów branżowych, współtwórcą projektu SpeakLeash i inicjatorem prac nad polskim modelem językowym Bielik AI.